Microsoft가 AI Red Team의 오래된 경험을 바탕으로 Lessons from Red Teaming 100 Generative AI Products Whitepaper를 공개했음.
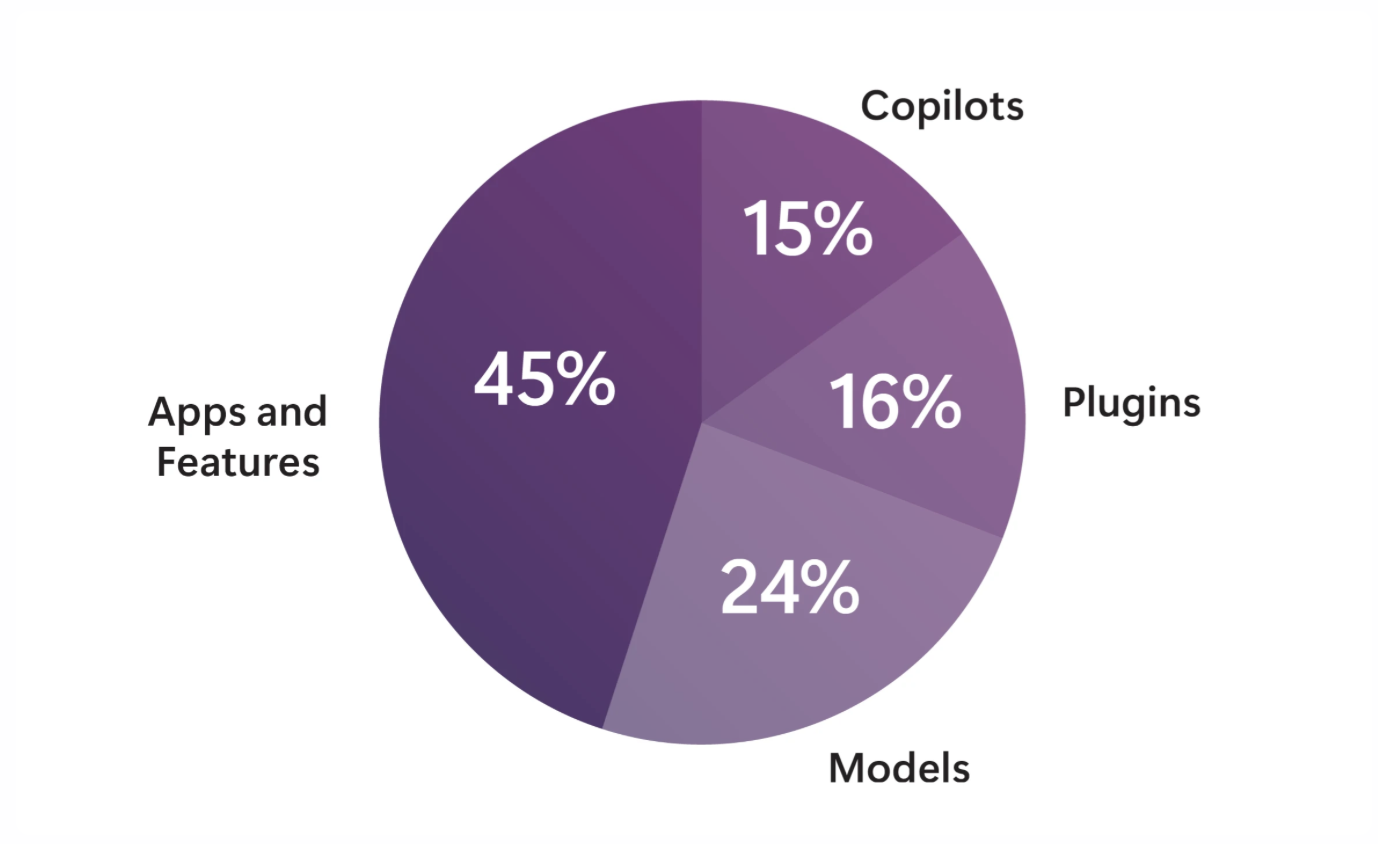
1. 기존 보안 위험과 새로운 AI 위험
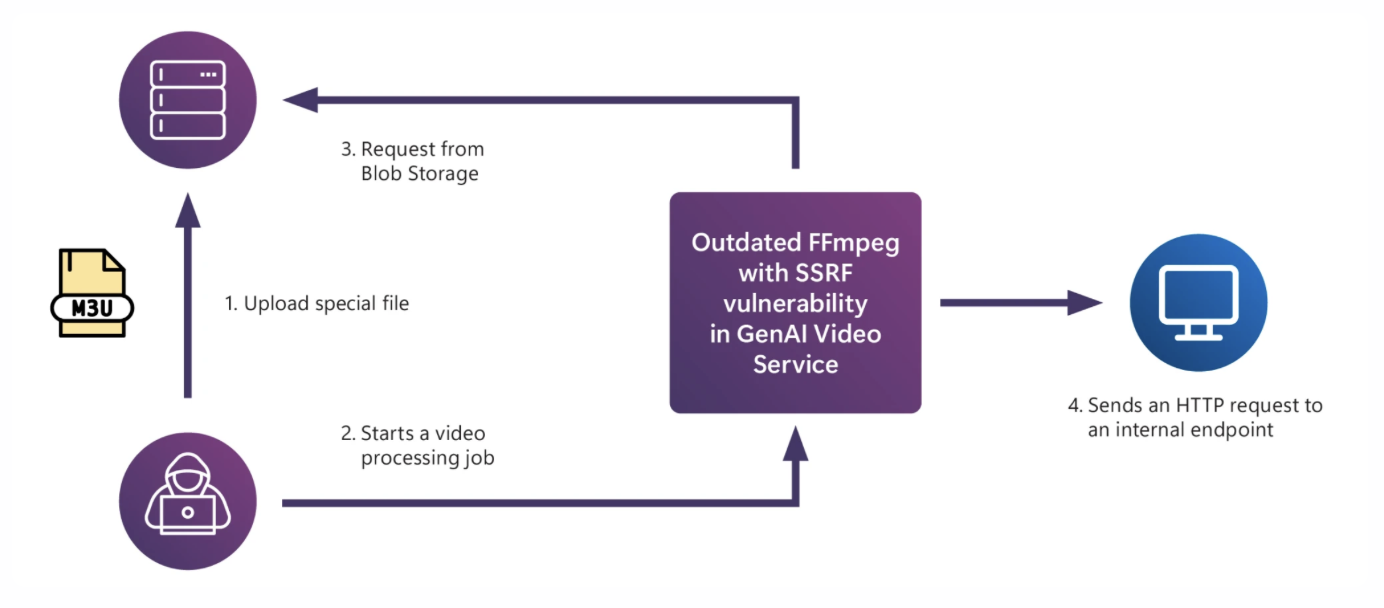
Generative AI가 Application에 들어오면서 새로운 Attack Vector가 등장했지만, 그렇다고 기존 Cybersecurity 문제가 사라진 것은 아니다. Microsoft는 AI Security를 이야기할 때 Prompt Injection이나 Jailbreak 같은 새로운 공격에만 집중하면 안 된다고 강조한다. 기존 Application에서도 발생하던 오래된 Dependency 사용, 잘못된 Error Handling, Source Code에 포함된 Credential, Input과 Output Sanitization 부족, 안전하지 않은 Packet Encryption 등의 문제가 AI Application에서도 그대로 발생할 수 있다. Whitepaper의 한 Case Study에서는 Video Processing AI Application에서 오래된 FFmpeg Component를 발견했다. 이 Component 때문에 이미 알려진 SSRF Server-Side Request Forgery Vulnerability가 발생했고, 공격자가 이를 악용해 System Privilege를 높일 가능성이 있었다.
AI를 사용하는 Application이라고 해서 모든 취약점이 AI에서 발생하는 것은 아니다. 기존 Software에서 발생하던 Security Engineering 문제가 AI Application에서도 그대로 발생할 수 있다. 반대로 AI Model 자체가 새로운 Attack Surface를 만들기도 한다. 대표적인 예가 Prompt Injection이다. AI Model은 System Level Instruction과 User Data를 제대로 구분하지 못할 수 있는데, 공격자는 이러한 특성을 이용해 Model의 동작을 조작한다. Microsoft는 Whitepaper에서 실제 Vision Language Model을 Prompt Injection으로 조작한 Red Teaming Case Study도 소개한다.
따라서 AI Red Team은 기존 Application Security Vulnerability + AI Model에서 새롭게 발생하는 Vulnerability 두 영역을 모두 살펴봐야 한다. Microsoft는 AI Security에서도 기본적인 Cyber Hygiene을 놓치지 않는 것이 중요하다고 강조한다.
2. AI Red Teaming과 사람의 역할
두 번째 교훈은 AI Red Teaming을 완전히 자동화할 수 없다는 것이다. 자동화 Tool은 Prompt를 생성하거나 Attack을 Orchestration하고 Model Response를 평가하는 데 유용하다. 하지만 Microsoft는 AI Red Teaming에서 여전히 사람의 전문성이 중요하다고 설명한다.
첫 번째 이유는 Subject Matter Expertise다. LLM은 Model의 Response에 Hate Speech나 Explicit Sexual Content가 포함됐는지 어느 정도 평가할 수 있다. 하지만 Medicine, Cybersecurity, CBRN Chemical Biological Radiological Nuclear처럼 전문 지식이 필요한 분야에서는 신뢰성이 떨어질 수 있다. 따라서 이런 영역의 위험성을 정확하게 판단하려면 해당 분야 전문가가 필요하다.
두 번째는 Cultural Competence다. 현대 LLM의 Training Data, Benchmark, Safety Evaluation 상당 부분은 영어 중심이다. 하지만 AI는 전 세계에서 사용된다. 같은 내용이라도 언어나 정치적·문화적 환경에 따라 Harm의 의미가 달라질 수 있기 때문에 다양한 언어와 문화적 배경을 가진 사람이 Red Teaming 과정에 참여해야 한다.
세 번째는 Emotional Intelligence다. 예를 들어 Microsoft는 Whitepaper의 Case Study에서 심리적으로 어려움을 겪고 있는 User에게 Chatbot이 어떻게 대응하는지를 평가했다. 이런 Psychosocial Harm은 단순한 자동화 Evaluation만으로 판단하기 어렵다. 따라서 Microsoft는 PyRIT 같은 Tool을 이용해 Red Teaming을 확장하고 자동화하되 Human-in-the-loop 구조를 유지해야 한다고 설명한다.
3. Defense in Depth
마지막 교훈은 하나의 보안 대책으로 AI System을 완전히 보호할 수 없다는 것이다. AI Safety와 Security를 위한 여러 Mitigation이 개발되고 있지만 어떤 방어 방법도 Risk를 완전히 제거하지는 못한다. 따라서 AI Red Teaming 역시 한 번 수행하고 끝내는 작업이 아니라 계속 반복해야 하는 Process로 봐야 한다. 특히 AI System의 성능이 발전하면서 기존에는 없었던 새로운 Harm Category가 등장할 수 있다.
Microsoft는 예시로 최신 LLM이 사람을 설득하는 Persuasive Capability를 위험하게 사용할 가능성을 평가한 Case Study를 언급한다. AI의 Capability가 달라지면 Red Team 역시 새로운 Risk를 예상하고 새로운 Test를 만들어야 한다. 여기서 Microsoft는 Cybersecurity의 경제적인 관점도 강조한다. 어떤 System도 완벽하게 안전하게 만들 수는 없다. 사람은 실수할 수 있고 공격자는 계속해서 새로운 공격 방법을 시도하기 때문이다. 따라서 목표를 공격을 100% 불가능하게 만드는 것으로 잡기보다는 공격자가 성공하기 위해 지불해야 하는 Cost를 최대한 높이는 것으로 보는 것이다.
이를 위해 Microsoft는 Break-Fix Cycle을 제시한다. Red Teaming으로 취약점을 찾고 → Risk를 측정하고 → Mitigation을 적용하고 → 다시 Red Teaming하고 → 다시 보완한다. 이 과정을 반복하면서 System이 다양한 공격을 견딜 수 있도록 강화한다. 이러한 반복적인 Red Teaming과 Defense 과정은 Purple Teaming이라고도 설명한다.
마지막으로 Microsoft는 AI Safety와 Security를 기업만의 문제로 보지 않는다. 기업의 방어 노력뿐 아니라 정부 차원의 정책과 대응도 필요하며 Public Sector와 Private Sector가 모두 지속적으로 AI Risk에 대응해야 한다고 설명한다.
3 takeaways from red teaming 100 generative AI products | Microsoft Security Blog
The growing sophistication of AI systems and Microsoft’s increasing investment in AI have made red teaming more important than ever. Learn more.
www.microsoft.com
'AI + Security' 카테고리의 다른 글
| 여러 가지 Jailbreak 방법 (0) | 2025.07.11 |
|---|---|
| Google Cloud AI Protection (0) | 2025.07.08 |
| AI 시대의 Zero Trust (0) | 2025.05.13 |
| DeepSeek도 탈옥할 수 있을까? DeepSeek Jailbreak 공격 분석 (0) | 2025.04.13 |
| ArtPrompt Jailbreak - ASCII Art로 LLM의 안전장치 우회하기 (0) | 2025.03.30 |