요즘 떠들석한 딥시크. 관련 내용을 찾아보고 정리해보았다.

1. DeepSeek란
DeepSeek는 2023년 중국에서 설립된 AI 기업이다. DeepSeek는 처음부터 거대한 상용 AI 서비스를 만드는 방식보다는 LLM 연구와 모델 개발에 집중해왔다. 주요 목표는 AGI 즉 Artificial General Intelligence를 연구하고 개발하는 것.
AGI : 특정 작업만 수행하는 AI가 아니라 다양한 분야의 문제를 이해하고 해결할 수 있는 범용 인공지능
이후 2025년 1월 20일 추론 모델인 DeepSeek R1을 공개하면서 전 세계적으로 큰 관심을 받기 시작했음. DeepSeek는 R1의 성능이 수학과 코드 및 자연어 추론 등의 작업에서 OpenAI o1과 비슷한 수준이라고 발표했다.
2. DeepSeek만의 기술(MoE, MLA)
MoE :Mixture of Experts. 하나의 거대한 모델 전체를 매번 사용하는 대신 여러 Expert를 두고 입력에 따라 필요한 Expert 일부를 선택해서 사용하는 방식이다. 쉽게 말하면 하나의 질문을 해결하기 위해 회사의 모든 직원을 불러오는 것이 아니라 해당 문제에 필요한 전문가들만 불러서 처리하는 것과 비슷하다.
따라서 모델의 전체 규모를 크게 유지하면서 실제 연산에 사용되는 파라미터 수는 줄일 수 있다. DeepSeek V3는 전체 671B 파라미터 중 토큰마다 약 37B를 활성화하는 구조를 사용한다.
기존 LLM 경쟁에서는 모델을 얼마나 크게 만들 수 있는지가 중요한 요소였다면 DeepSeek는 비슷한 성능을 얼마나 적은 연산 자원으로 만들어낼 수 있는지를 보여주면서 주목받기 시작했음.
MLA : Multi Head Latent Attention. Transformer 기반 LLM에서 Attention을 처리할 때 필요한 메모리와 연산 비용을 줄이기 위해 고안된 구조
3. DeepSeek R1
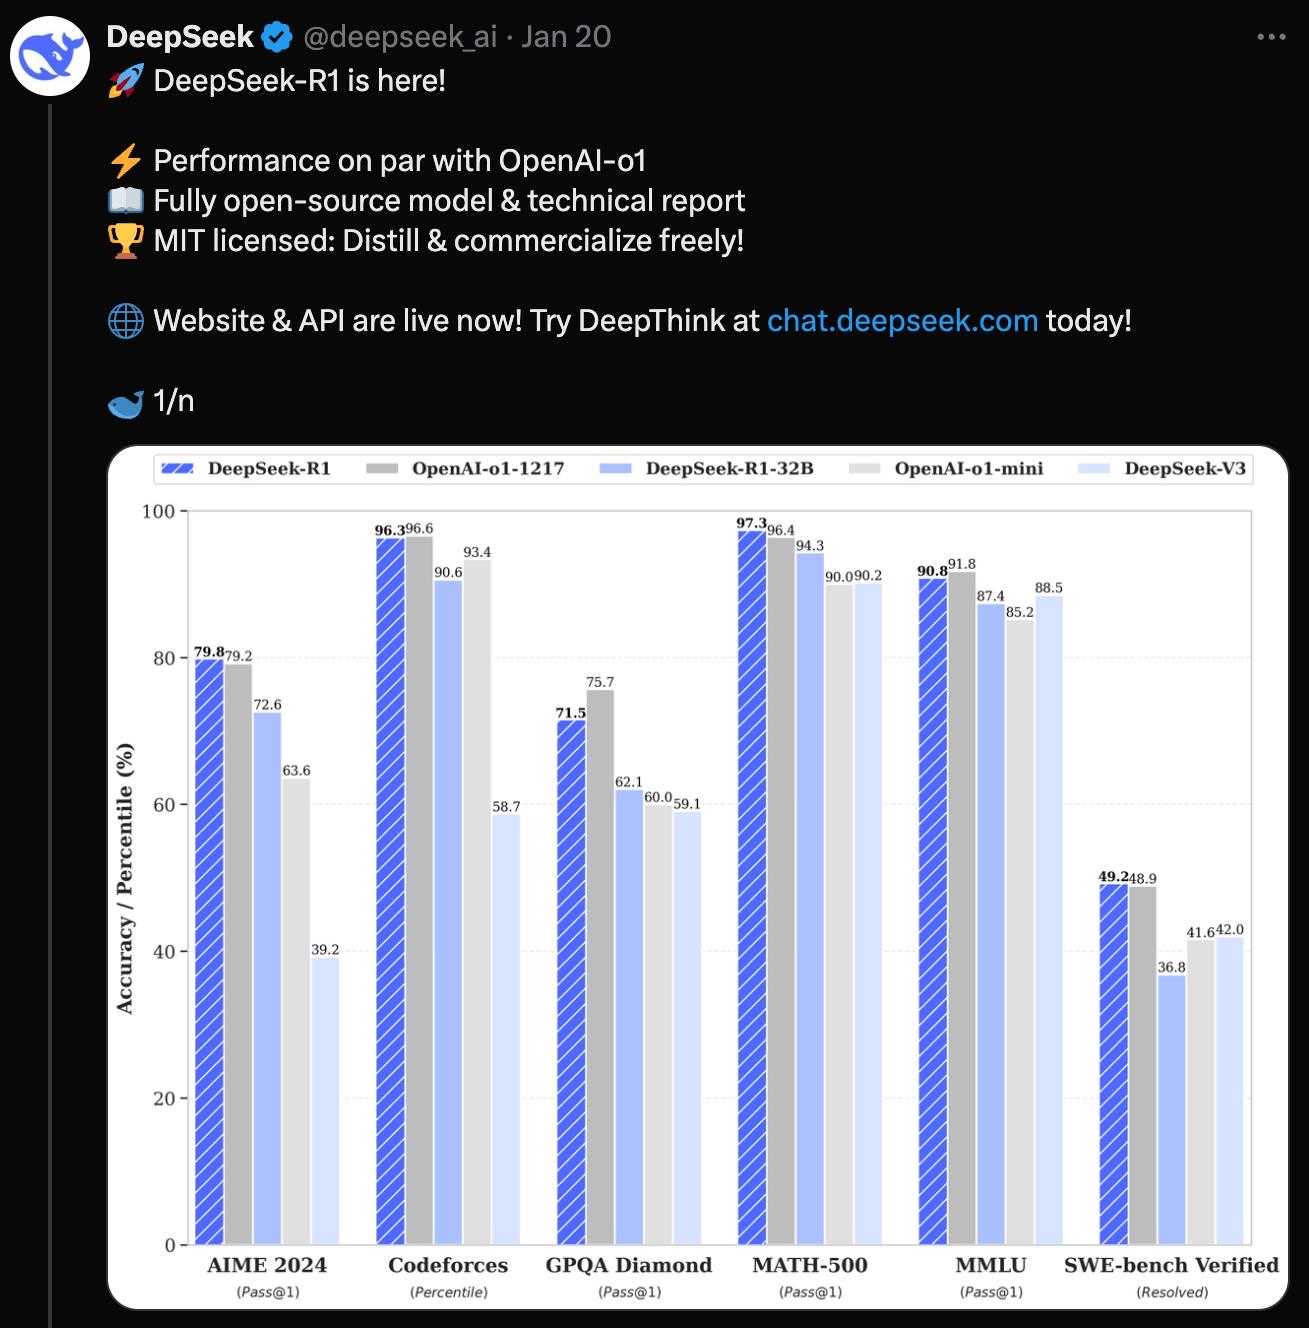
그리고 며칠 전 DeepSeek R1이 공개됐다. DeepSeek R1은 일반적인 대화 능력보다는 추론 능력에 초점을 맞춘 모델이다. 수학 문제나 프로그래밍 문제처럼 답을 바로 생성하기보다는 여러 단계의 사고 과정이 필요한 문제를 해결하도록 만들어졌다.
DeepSeek는 R1의 성능이 수학과 코드 및 자연어 추론 등의 작업에서 OpenAI의 o1과 비슷한 수준이라고 발표했다. R1에서 특히 흥미로운 부분은 강화학습을 적극적으로 사용했다는 점이다. 일반적인 LLM 개발에서는 사람이 작성한 정답이나 예제를 이용하는 지도 학습이 중요한 역할을 한다. 하지만 DeepSeek 연구진은 강화학습을 이용해 모델의 추론 능력을 향상시키는 방법을 실험했다.
4. 강화학습을 이용한 추론
DeepSeek R1이 주목받은 가장 큰 이유 중 하나는 강화학습을 통한 추론 능력 향상이다. 강화학습은 모델이 어떤 행동을 했을 때 그 결과에 따라 보상을 제공하면서 더 좋은 행동을 학습하도록 만드는 방식이다.
예를 들어 수학 문제를 해결한다고 가정한다. 모델이 여러 방법으로 문제를 풀어보고 정답에 도달한 경우 높은 보상을 받는다. 반대로 잘못된 답에 도달하면 낮은 보상을 받는다. 이 과정을 반복하면서 모델은 어떤 방식으로 추론해야 정답에 도달할 가능성이 높은지를 학습하게 된다.
DeepSeek R1 연구에서는 이러한 강화학습을 대규모로 적용해 추론 능력을 향상시켰음.
즉 사람이 모든 사고 과정을 직접 작성해서 모델에게 알려주는 방식에서 벗어나 모델이 반복적인 시도를 통해 문제 해결 전략을 학습하도록 한 것이다.
이미지
5. DeepSeek와 OpenAI의 차이
DeepSeek가 자주 OpenAI와 비교되지만 두 기업의 모든 모델을 단순하게 비교하기는 어렵다. DeepSeek V3는 일반적인 LLM에 가깝고 DeepSeek R1은 추론에 특화된 모델이기 때문에 각각 비교 대상이 달라진다. 특히 R1은 OpenAI의 o1과 비교되는 경우가 많다.
DeepSeek가 공개한 평가 결과에서는 R1이 수학과 코딩 및 일부 추론 벤치마크에서 o1과 경쟁할 수 있는 성능을 보여줬다. 다만 벤치마크 결과가 실제 모든 사용 환경에서 동일한 성능을 의미하는 것은 아니다. 중요한 부분은 DeepSeek가 상대적으로 낮은 비용과 공개된 모델을 통해 최상위권 추론 모델에 접근할 수 있는 새로운 방법을 보여줬다는 점이다.
10. 정리 : DeepSeek 3가지 키워드
1) AI 모델의 효율성이다. 기존에는 모델 규모와 컴퓨팅 자원을 계속 증가시키는 Scaling이 AI 발전의 중요한 방법으로 여겨졌다. DeepSeek는 MoE와 MLA 그리고 FP8 학습 등의 기술을 조합하면서 계산 자원을 효율적으로 사용하는 방법을 보여줬다.
2) 추론 모델의 오픈소스화다.
OpenAI o1과 같은 추론 모델이 등장하면서 AI 업계에서는 Reasoning Model이 중요한 연구 방향으로 떠오르고 있었다. DeepSeek는 R1과 R1 Zero의 모델 가중치와 기술 보고서를 공개하면서 이러한 추론 모델 연구에 더 많은 개발자가 접근할 수 있도록 했다.
3) 강화학습의 가능성이다. R1 Zero 실험에서는 지도 미세조정을 먼저 수행하지 않은 상태에서도 강화학습을 통해 추론 행동이 나타나는 모습을 확인했다. 이는 앞으로 LLM의 추론 능력을 향상시키는 과정에서 강화학습이 더욱 중요한 역할을 할 가능성을 보여준다.
11. 한계와 논란
물론 DeepSeek를 둘러싼 우려도 존재한다. 대표적인 것이 데이터와 개인정보 문제다. DeepSeek가 중국 기업이라는 점 때문에 사용자 데이터 처리와 국가 안보 문제에 대한 우려가 미국을 비롯한 여러 국가에서 제기됐다. 2025년 1월 미국 백악관은 DeepSeek가 국가 안보에 미칠 수 있는 영향을 검토하고 있다고 밝혔다. 또 다른 건 AI 반도체를 둘러싼 경쟁이다. 미국은 중국에 대한 고성능 AI 반도체 수출을 제한해왔는데 DeepSeek의 등장 이후 이러한 규제가 실제 중국의 AI 개발을 얼마나 억제할 수 있는지를 두고 다시 논쟁이 일어나고 있음.
아래 링크를 참고하여 작성하였음.
DeepSeek | 深度求索
深度求索(DeepSeek),探索未至之境。专注于研究世界领先的通用人工智能底层模型与技术,开源 DeepSeek-V4、DeepSeek-R1 等前沿大模型。和 DeepSeek AI 对话,轻松接入 API。
www.deepseek.com
'AI + Security' 카테고리의 다른 글
| AI Jailbreak의 공격 원리와 방어 전략 (0) | 2025.02.07 |
|---|---|
| LLM을 공격하는 17가지 방법, Prompt Injection 공격 유형 총정리 (0) | 2025.02.04 |
| 실제 해커들은 AI를 어떻게 사용할까? Google이 분석한 Gemini 악용 사례 (0) | 2025.01.30 |
| Top 10 AI security (0) | 2025.01.26 |
| 보안과 인공지능을 결합하는 시대 (0) | 2025.01.17 |